Toda empresa de IA diz que seu modelo é o melhor em finanças. Isso é marketing, não evidência. Então coloquei os modelos à prova em um benchmark real, independente, construído com Stanford, e depois reproduzi toda a execução eu mesmo com o Claude no meio como juiz neutro. Veja o que os números realmente dizem.
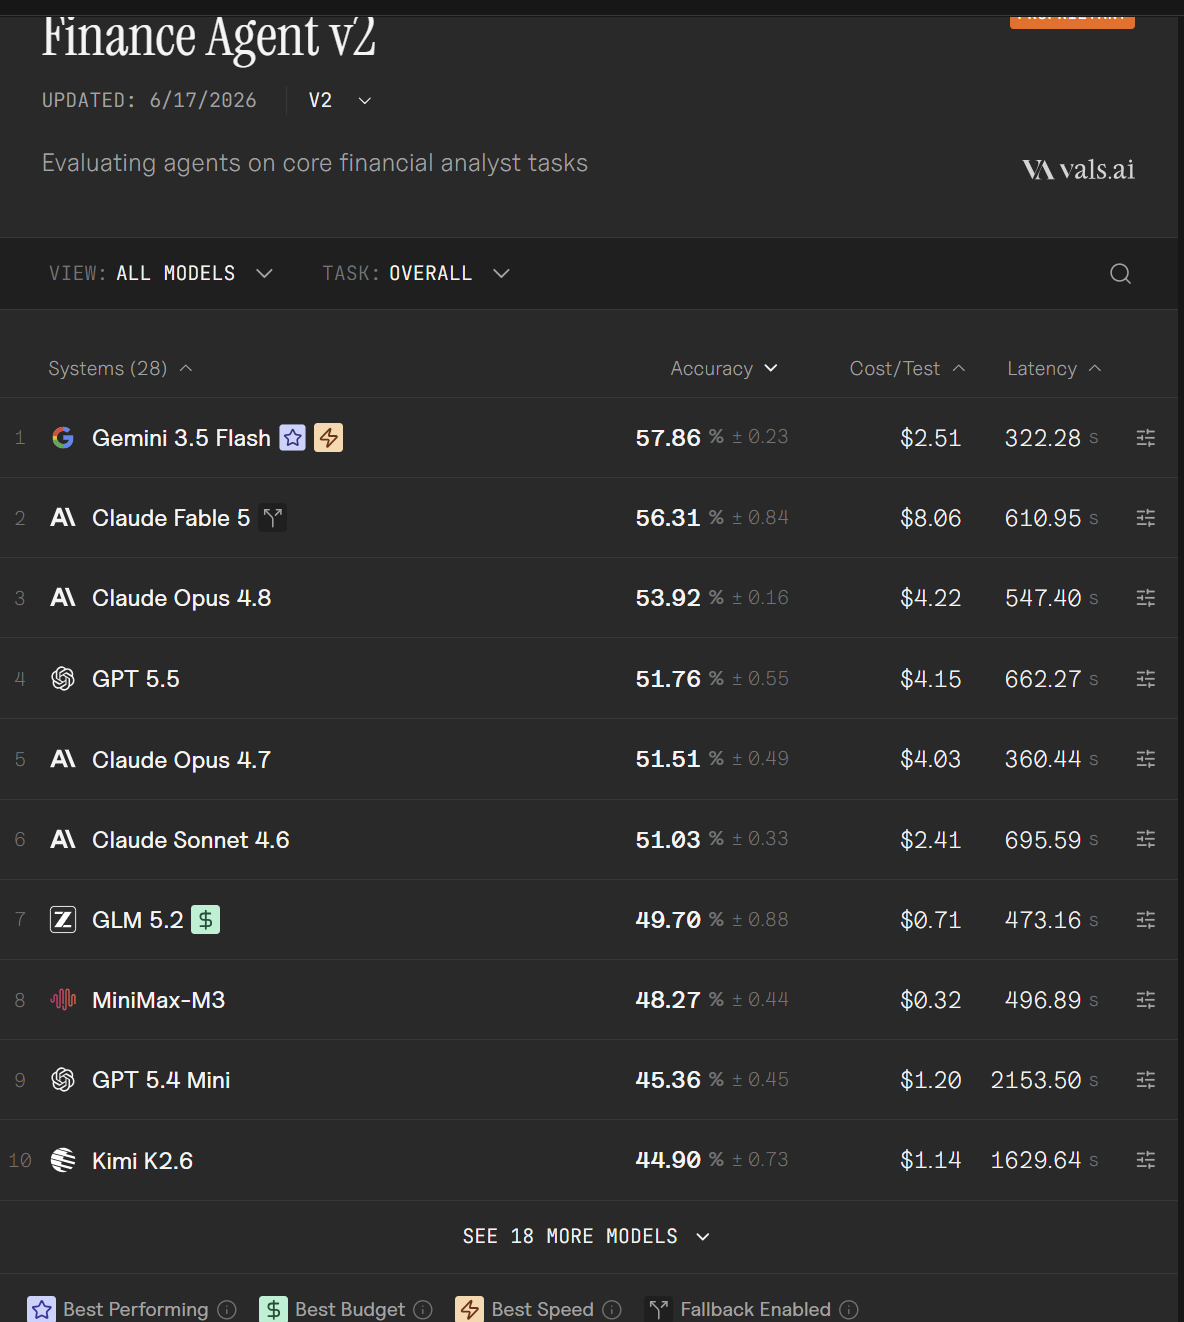
Leia isto primeiro: o ranking desta página é um retrato de 4 de julho de 2026. Esses rankings de IA mudam o tempo todo: novos modelos entram e todos são reavaliados a cada poucas semanas. Quando você ler isto, a ordem pode estar completamente diferente, ou até invertida. Trate os números abaixo como ilustração do método, não como a verdade de hoje. Para a classificação atual, consulte sempre o ranking ao vivo do Finance Agent: vals.ai/benchmarks/fabv2.
A Anthropic diz que o Claude é o melhor. A OpenAI diz GPT. O Google diz Gemini. A Microsoft diz Copilot. Em finanças, isso é só ruído. Resolver uma equação não tem nada a ver com ler um 10-K e pegar a nota de rodapé que quebra um valuation. Você não precisa do modelo que é o melhor num slide, precisa do que é o melhor no seu trabalho.
É exatamente isso que o benchmark Finance Agent da vals.ai mede. É um benchmark independente, desenvolvido com pesquisadores de Stanford, que avalia os principais modelos em trabalho real e específico do setor. Ele dá a cada modelo um conjunto de ferramentas, aponta para documentos da SEC e o faz pesquisar a resposta como um analista júnior faria. O harness completo é open source em github.com/vals-ai/finance-agent-v2.
A IA número um em finanças neste retrato não é o Claude, nem o GPT. É o Gemini 3.5 Flash, com cerca de 58%, seguido de perto pelo Claude Fable 5 com 56% e pelo Claude Opus 4.8 com 54%. As notas no topo são próximas, e é exatamente por isso que a ordem não para de mudar.
Quebre a nota por tarefa e a manchete se desfaz. Não existe uma única melhor IA para finanças, depende do trabalho. O Gemini Flash vence em análise de resultados com 79% e em análise de mercado com 74%. Mas um modelo Claude leva o trabalho quantitativo com cerca de 81% e a análise de divulgações com 69%, as tarefas de leitura profunda em que é preciso ter o documento inteiro na cabeça.
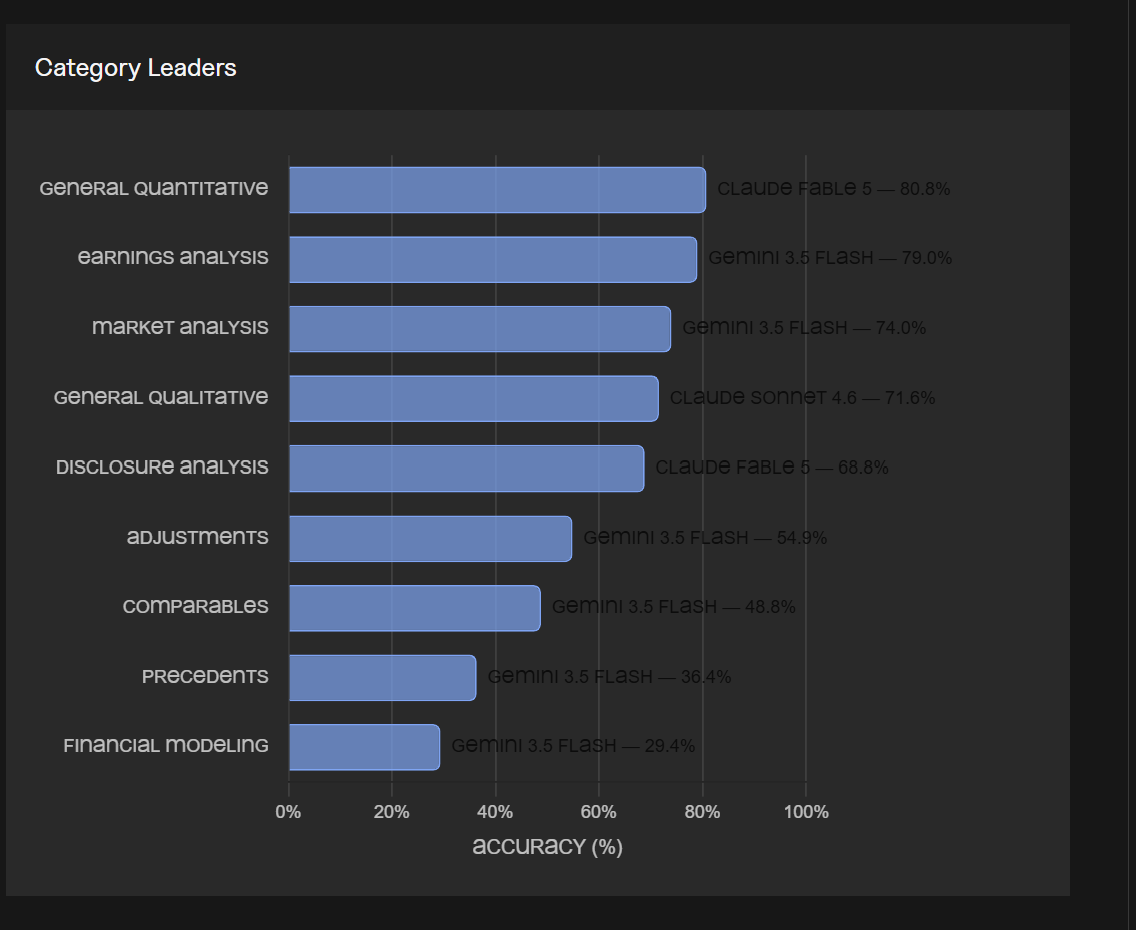
Essa última barra é o número mais importante da página. Modelagem financeira é onde todo modelo é mais fraco. A regra sai sozinha: deixe a IA ler, analisar e explicar, e mantenha o modelo nas suas mãos.
| Tarefa | Líder | Nota |
|---|---|---|
| Geral | Gemini 3.5 Flash | 57.86% |
| Geral, segundo | Claude Fable 5 | cerca de 56% |
| Geral, terceiro | Claude Opus 4.8 | cerca de 54% |
| Quantitativo geral | Claude Fable 5 | 80.8% |
| Análise de resultados | Gemini 3.5 Flash | 79% |
| Análise de mercado | Gemini 3.5 Flash | 74% |
| Análise de divulgações | Um modelo Claude | 69% |
| Modelagem financeira | Melhor nota entre todos os modelos | 29.4% |
Coloque cada modelo num gráfico de acurácia versus preço por tarefa e a conclusão aparece. O Gemini Flash não é só o mais preciso, é também um dos mais baratos entre os líderes, cerca de $2,51 por tarefa, no canto superior esquerdo, onde você quer estar. Os modelos premium ficam à direita, custando três a quatro vezes mais, por um ou dois pontos a menos de acurácia.
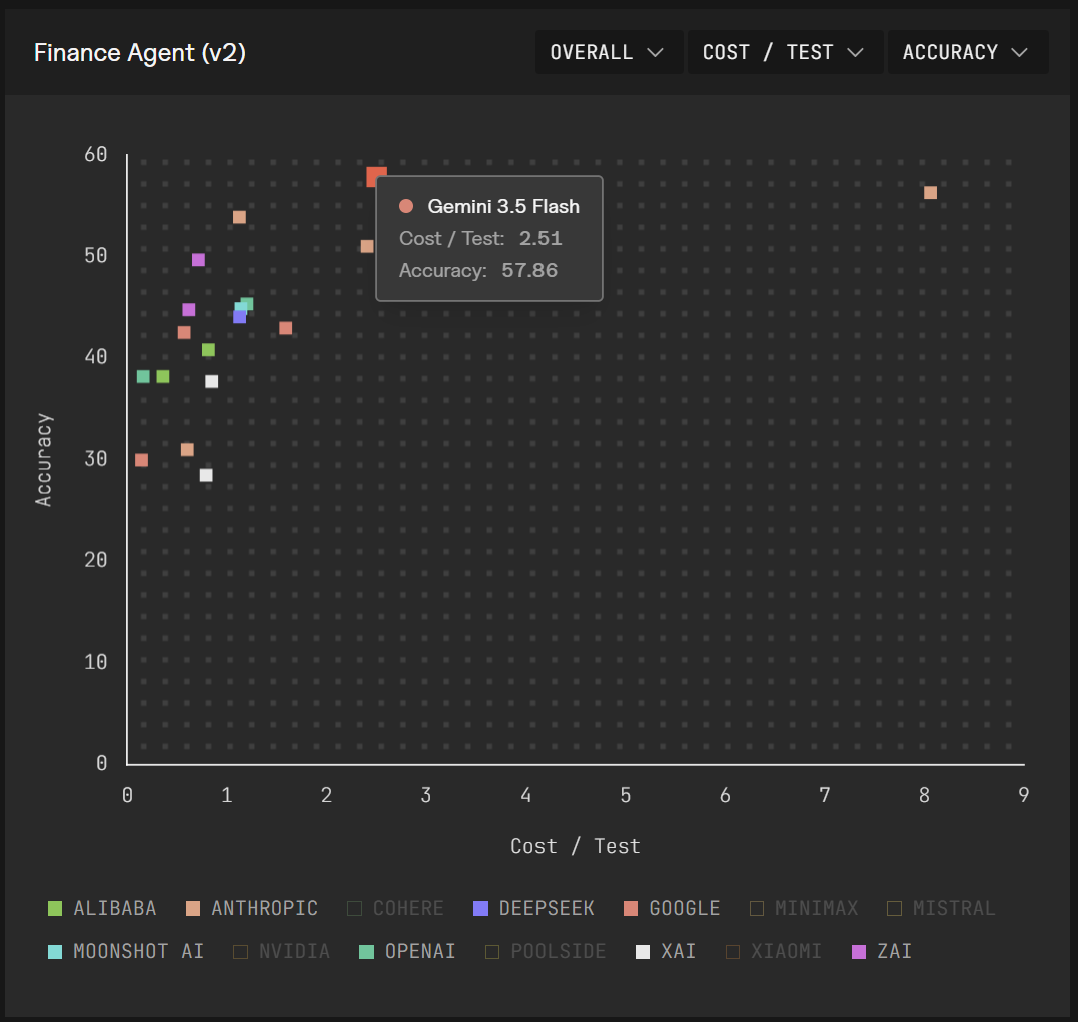
O melhor modelo para finanças hoje não é o Claude nem o GPT, e ainda é um dos mais baratos.
O benchmark está documentado em um paper de 2025 de Antoine Bigeard, Langston Nashold, Rayan Krishnan e Shirley Wu, intitulado Finance Agent Benchmark: Benchmarking LLMs on Real-world Financial Research Tasks. Ele se baseia em 537 perguntas escritas por especialistas, com contribuições de profissionais de banking, hedge fund e private equity, distribuídas em nove categorias de trabalho de analista: quantitativo, análise de resultados, análise de mercado, análise de divulgações, ajustes, comparáveis, precedentes, modelagem financeira e raciocínio qualitativo geral. Para dar ideia da dificuldade, no paper até o modelo mais forte acertou só 46,8% das perguntas, a um custo médio de $3,79 por consulta.
Citação completa: Bigeard, A., Nashold, L., Krishnan, R., & Wu, S. (2025). Finance Agent Benchmark: Benchmarking LLMs on Real-world Financial Research Tasks. arXiv:2508.00828.
A avaliação é a parte honesta, e se resume a quatro passos:
A nota de uma pergunta é a fração dos itens da rubrica atendidos, e a nota geral é a média disso entre todas as perguntas. Não há crédito parcial por soar confiante, só por bater com a checklist, e é exatamente por isso que um modelo que escreve uma resposta fluente mas errada tira nota baixa. Como o padrão é uma checklist fixa e não uma impressão, a mesma régua vale para todos os modelos e o resultado é reproduzível.
O melhor é que o harness é open source, então você pode ver as perguntas reais, os tickers reais e exatamente o que o agente faz.
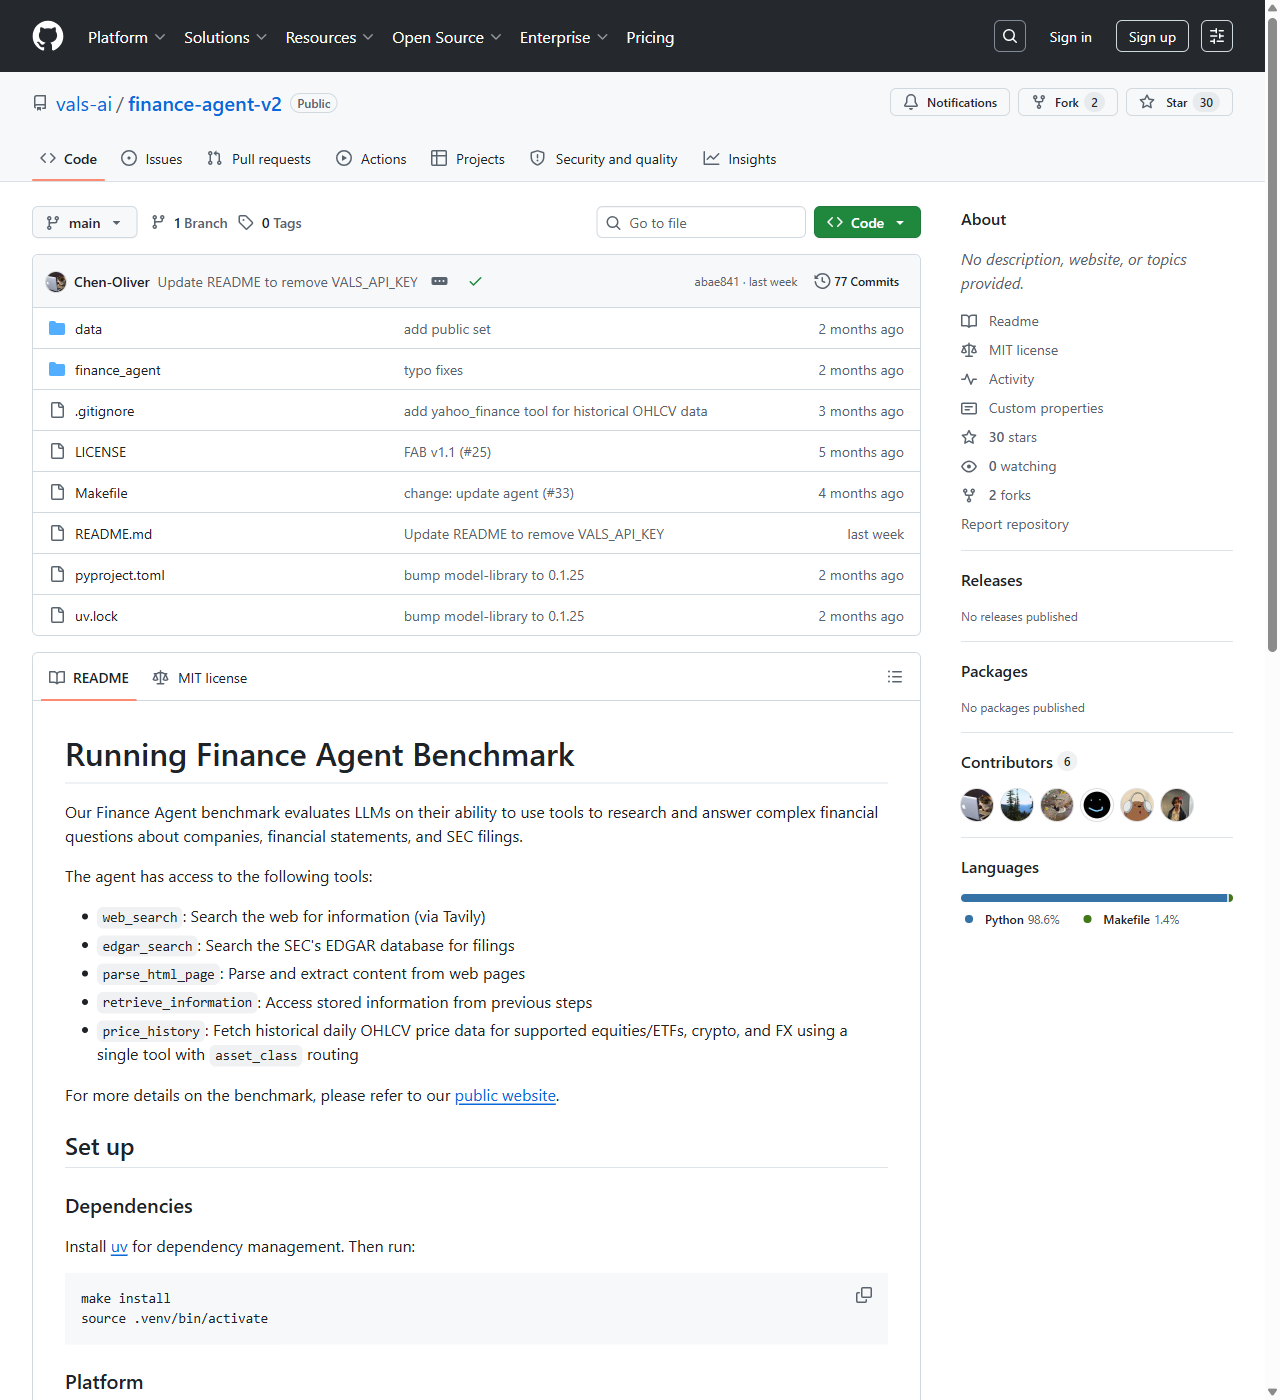
A estrutura é pequena e fácil de ler. data/ contém public.csv, o conjunto público de perguntas com suas rubricas. finance_agent/ é o pacote Python que faz o trabalho: run_agent.py é o ponto de entrada que entrega as ferramentas ao modelo escolhido e o executa em uma pergunta, e tools.py define as cinco ferramentas que o agente pode chamar: busca de documentos no EDGAR, busca na web, parsing de páginas HTML, recuperação de informações armazenadas e histórico de preços. O Makefile instala tudo, e pyproject.toml com uv.lock fixam as dependências. Por cima disso, adicionei meu próprio run_bench.py, um wrapper com checkpoints que roda o harness uma pergunta por vez e salva cada resposta, para que um travamento ou uma chave esgotada nunca perca nem cobre de novo o trabalho já feito.
Para rodar, você conecta algumas APIs: Tiingo para dados de mercado e preços, EDGAR para busca de documentos pela API da SEC, e Tavily para busca na web. Todas têm planos gratuitos, mas o da SEC é minúsculo e se esgota rápido, então na prática você cria algumas contas e alterna várias chaves (uma lista simples separada por ponto e vírgula, rotacionada a cada chamada) para manter viva uma execução longa.
Você escolhe os modelos: quaisquer IAs que quiser comparar, basta adicionar as chaves, então não fica preso aos meus dois. Mas atenção: isso não é gratuito nem rápido. Cada pergunta faz o modelo agir como um analista de verdade, com uma dúzia ou mais de chamadas de ferramentas, documentos ao vivo e buscas reais na web, então cada pergunta custa dinheiro real de API e pode levar vários minutos de tempo real. Rodar o conjunto completo de 537 perguntas em dois modelos pode pesar na conta de API e tomar boa parte de um dia inteiro, então comece com um piloto pequeno antes de partir para a rodada completa.
Existe um limite de tempo por pergunta que você define com --max-time, e errar nisso arruína uma execução sem avisar. Primeiro tentei um limite apertado, de cerca de 400 segundos, e simplesmente não foi suficiente para o Gemini: como agente, ele faz muitas chamadas de ferramentas por pergunta e batia no teto no meio da pesquisa, estourava o tempo e a resposta voltava vazia. Subir o limite para cerca de 1000 segundos ou mais resolveu. O GPT barato é rápido e não faz raciocínio, então termina bem dentro dos 400 segundos, mas os modelos agênticos fortes são lentos e deliberados, então planeje limites longos por pergunta e execuções totais longas.
Um hábito que vale manter antes de rodar qualquer coisa que você baixa do GitHub, incluindo este repositório: verifique a fonte e adicione suas próprias proteções primeiro. Toda hora aparecem notícias sobre código malicioso escondido em repositórios e pacotes, então confira quem é de fato o autor, confirme que está no projeto real e não num fork imitador, e leia os scripts de ponto de entrada para ver o que executam e o que enviam pela rede antes de rodá-los. Nunca rode uma etapa de cadastro ou de "desbloqueio" que peça seu nome ou e-mail, e só conecte suas chaves de API quando estiver convencido de que é seguro. É exatamente por isso que a primeira coisa que o prompt abaixo faz é obrigar o Claude a ler os pontos de entrada e provar que são seguros antes de rodar uma única linha.
Há uma peça que não é open source: o avaliador da vals.ai, a parte que de fato pontua as respostas. Então construí o meu. Uso o Claude Opus como orquestrador. Ele roda cada modelo pelas perguntas e depois avalia cada resposta contra a rubrica publicada pela vals.ai, um checklist exato do paper. Ele não é competidor e nunca responde a uma pergunta de finanças: seu único trabalho é rodar os modelos e depois julgá-los linha por linha. Mesma planilha de pontuação, mesmo padrão, sem favoritismo. Você não precisa mexer no repositório bruto nem gerenciar chaves manualmente para isso: pode apontar sua assinatura do Claude para o repositório público e deixá-lo montar a execução, adicionar as proteções e avaliar os resultados. Este é o prompt exato que usei:
Coloquei o atual número um, Gemini 3.5 Flash, contra um modelo propositalmente barato e desatualizado, o GPT-4.1 mini, para manter os custos de API razoáveis e mostrar a diferença bruta que o modelo faz. Cada resposta foi avaliada pelo Opus contra a rubrica da vals.ai, ponto a ponto, exatamente como descrito acima: cada item da rubrica marcado como acerto ou erro, mais uma checagem de contradição, e a nota é a fração de pontos acertados. No piloto, o Gemini acertou 95% dos pontos da rubrica e o GPT-4.1 mini acertou 25%. Isso não é uma diferença, é um abismo.
E o motivo não foi inteligência bruta. Numa pergunta sobre divulgação, o Gemini leu os dois 10-Ks e acertou. O modelo barato puxou o documento do ano errado, pegou dados de um site de screener de ações e concluiu exatamente o oposto. Quando você olha as respostas, o Gemini cita as URLs reais dos documentos na SEC, enquanto o modelo barato cita press releases e o MarketBeat. Essa é a história toda. Quando você não força um modelo a passar pela fonte primária, ele pega a mais próxima e conveniente, e em finanças a mais próxima e conveniente é como você acaba errado e confiante ao mesmo tempo.
O modelo barato não era burro. Ele só confiou na fonte mais próxima e conveniente em vez do documento oficial.
A verdadeira lição não é "use o Gemini". Os modelos mudam, as perguntas não. Monte o benchmark, force qualquer modelo a passar por fontes primárias e deixe um juiz neutro avaliá-lo contra uma rubrica fixa. É assim que você descobre qual IA é de fato a melhor no seu trabalho, e não a melhor no slide de alguém.
Fonte do benchmark: vals.ai Finance Agent v2. Harness open source: vals-ai/finance-agent-v2. Paper: Bigeard, Nashold, Krishnan & Wu (2025), arXiv:2508.00828. Todos os números do ranking são um retrato de 4 de julho de 2026 e já devem ter mudado; reproduza-os antes de citar.