Cada empresa de IA dice que su modelo es el mejor en finanzas. Eso es marketing, no evidencia. Así que los sometí a un benchmark real, uno independiente construido con Stanford, y luego reproduje toda la corrida yo mismo con Claude en el medio como juez neutral. Esto es lo que realmente dicen los números.
Lee esto primero: el ranking de esta página es una foto del 4 de julio de 2026. Estos rankings de IA cambian constantemente: se agregan modelos nuevos y cada modelo se vuelve a evaluar cada pocas semanas, así que cuando leas esto el orden puede ser completamente distinto, o incluso al revés. Toma los números exactos de abajo como una ilustración del método, no como la verdad de hoy. Para la clasificación actual, revisa siempre el leaderboard en vivo de Finance Agent: vals.ai/benchmarks/fabv2.
Anthropic dice que Claude es el mejor. OpenAI dice que GPT. Google dice que Gemini. Microsoft dice que Copilot. En finanzas, eso es solo ruido. Resolver una ecuación no se parece en nada a leer un 10-K y detectar la nota al pie que rompe una valuación. No necesitas el modelo que es el mejor en una diapositiva, necesitas el que es el mejor en tu trabajo.
Eso es exactamente lo que mide el benchmark Finance Agent de vals.ai. Es un benchmark independiente, desarrollado con investigadores de Stanford, que evalúa a los mejores modelos en trabajo real y específico del dominio. Le da a cada modelo un conjunto de herramientas, lo dirige a los reportes de la SEC y lo obliga a investigar la respuesta como lo haría un analista junior. Todo el harness es open source en github.com/vals-ai/finance-agent-v2.
La IA número uno en finanzas en esta foto no es Claude, ni GPT. Es Gemini 3.5 Flash con cerca de 58%, con Claude Fable 5 justo detrás con 56% y Claude Opus 4.8 con 54%. Los puntajes están muy cerca arriba, y por eso mismo el orden no deja de moverse.
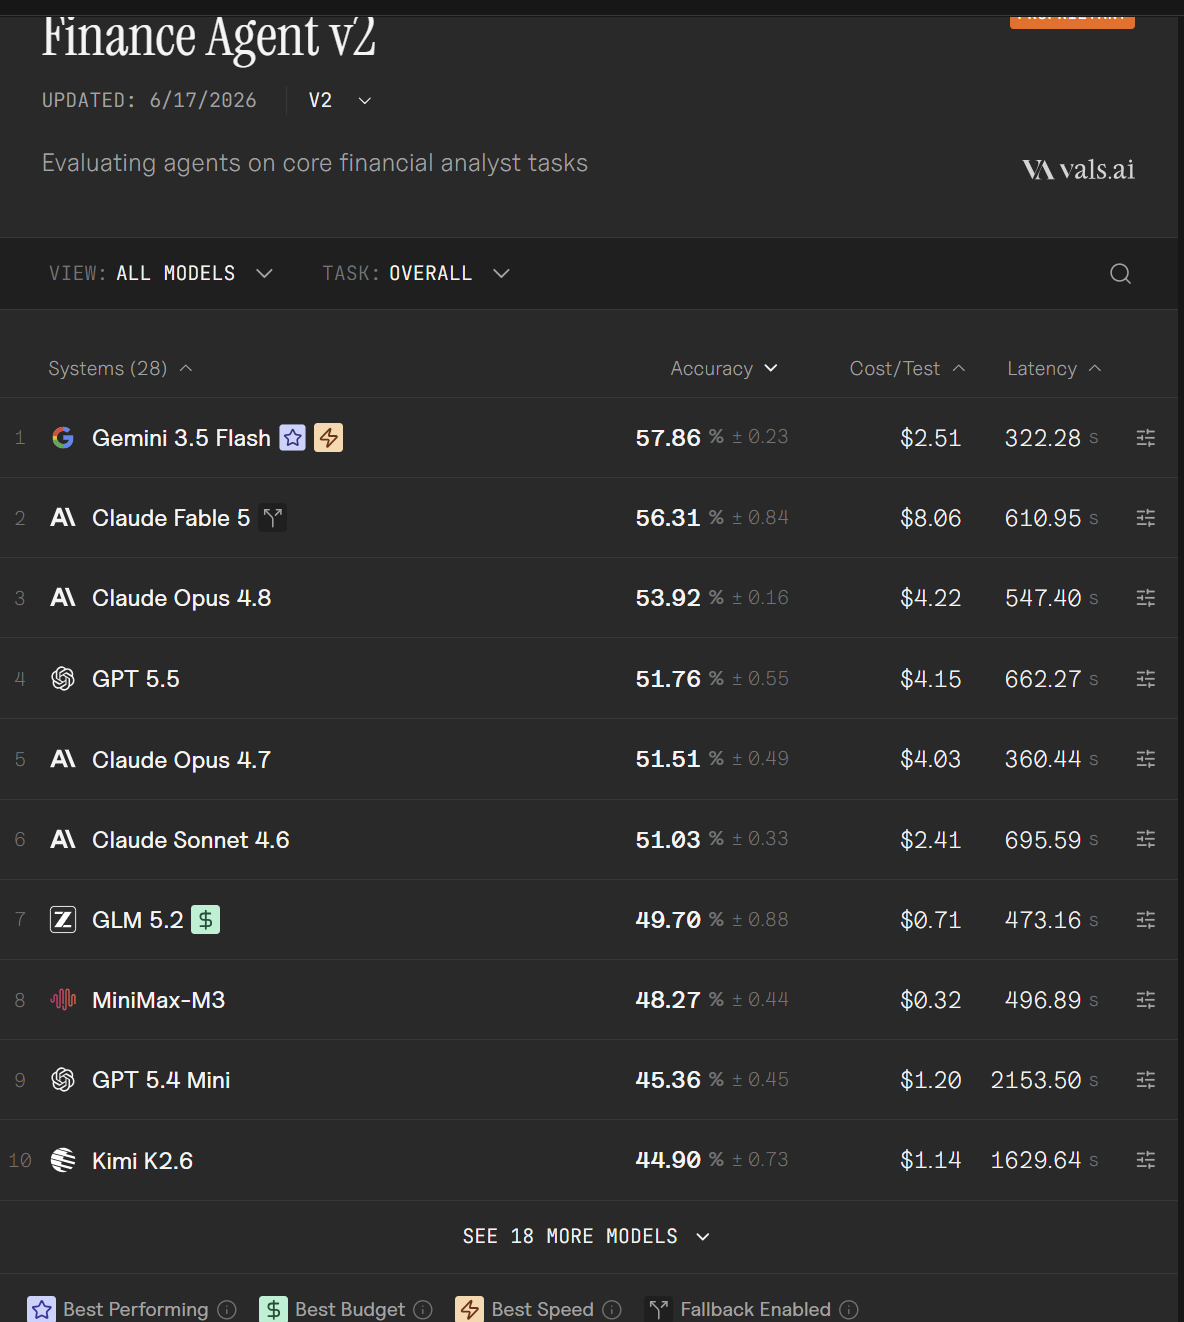
Desglosa el puntaje por tarea y el titular se desvanece. No existe una única mejor IA para finanzas, depende del trabajo. Gemini Flash gana en análisis de resultados con 79% y en análisis de mercado con 74%. Pero un modelo Claude se queda con el trabajo cuantitativo con cerca de 81% y el análisis de revelaciones con 69%, las tareas de lectura profunda donde tienes que tener todo un reporte en la cabeza.
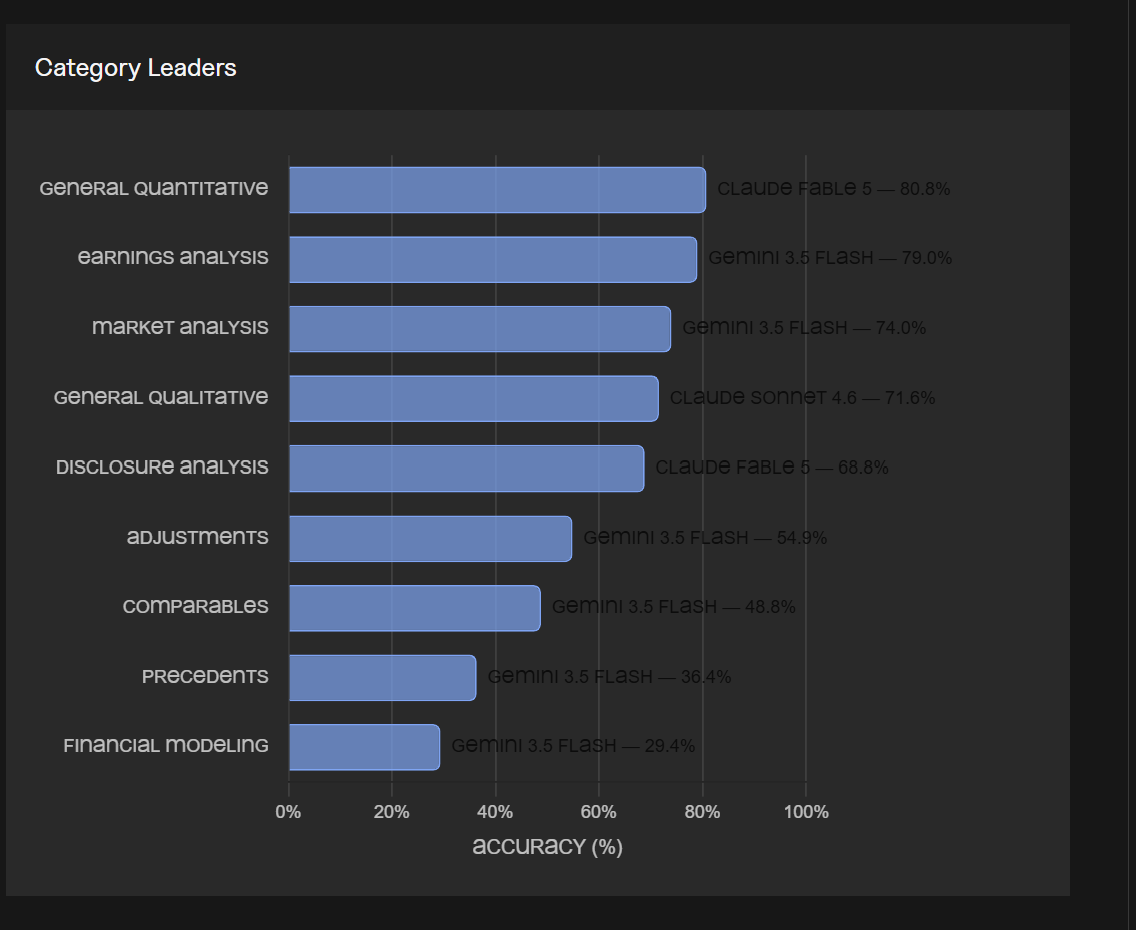
Esa barra de abajo es el número más importante de la página. La modelación financiera es donde todos los modelos son más débiles. Así que la regla sale sola: deja que la IA lea, analice y explique, y mantén tus propias manos en el modelo.
| Tarea | Líder | Puntaje |
|---|---|---|
| General | Gemini 3.5 Flash | 57.86% |
| General, segundo | Claude Fable 5 | cerca de 56% |
| General, tercero | Claude Opus 4.8 | cerca de 54% |
| Cuantitativo general | Claude Fable 5 | 80.8% |
| Análisis de resultados | Gemini 3.5 Flash | 79% |
| Análisis de mercado | Gemini 3.5 Flash | 74% |
| Análisis de revelaciones | Un modelo Claude | 69% |
| Modelación financiera | Mejor puntaje de cualquier modelo | 29.4% |
Grafica cada modelo por precisión y precio por tarea, y el remate es claro. Gemini Flash no solo es el más preciso, también es uno de los más baratos entre los líderes, cerca de $2,51 por tarea, ubicado en la esquina superior izquierda, donde quieres estar. Los modelos premium están a la derecha, a tres o cuatro veces el precio, con uno o dos puntos menos de precisión.
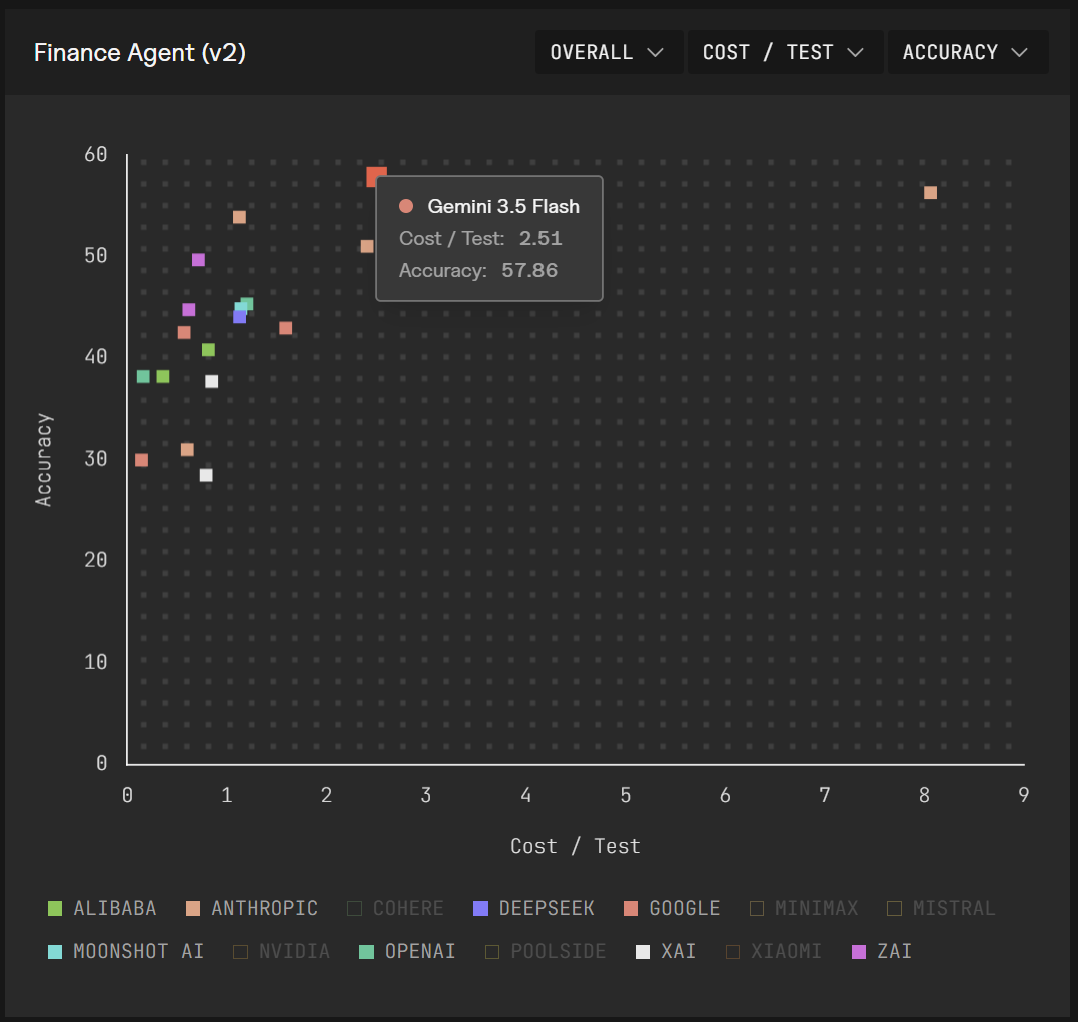
El mejor modelo para finanzas ahora mismo no es Claude ni GPT, y además es uno de los más baratos.
El benchmark está documentado en un paper de 2025 de Antoine Bigeard, Langston Nashold, Rayan Krishnan y Shirley Wu, titulado Finance Agent Benchmark: Benchmarking LLMs on Real-world Financial Research Tasks. Está construido con 537 preguntas escritas por expertos, con aportes de profesionales de banca, hedge funds y private equity, repartidas en nueve categorías del trabajo de un analista: cuantitativo, análisis de resultados, análisis de mercado, análisis de revelaciones, ajustes, comparables, precedentes, modelación financiera y razonamiento cualitativo general. Para dimensionar la dificultad: en el paper, incluso el modelo más fuerte resolvió solo el 46,8% de las preguntas, con un costo promedio de $3,79 por consulta.
Cita completa: Bigeard, A., Nashold, L., Krishnan, R., & Wu, S. (2025). Finance Agent Benchmark: Benchmarking LLMs on Real-world Financial Research Tasks. arXiv:2508.00828.
La calificación es la parte honesta, y se reduce a cuatro pasos:
El puntaje de una pregunta es la proporción de sus puntos de rúbrica que se cumplieron, y el puntaje general promedia eso en todas las preguntas. No hay crédito parcial por sonar seguro, solo por cumplir la lista, y por eso un modelo que escribe una respuesta fluida pero equivocada sale mal. Como el estándar es una lista fija y no una impresión, la misma tarjeta de puntaje aplica a todos los modelos y el resultado es reproducible.
Lo mejor es que el harness es open source, así que puedes ver las preguntas reales, los tickers reales y exactamente lo que hace el agente.
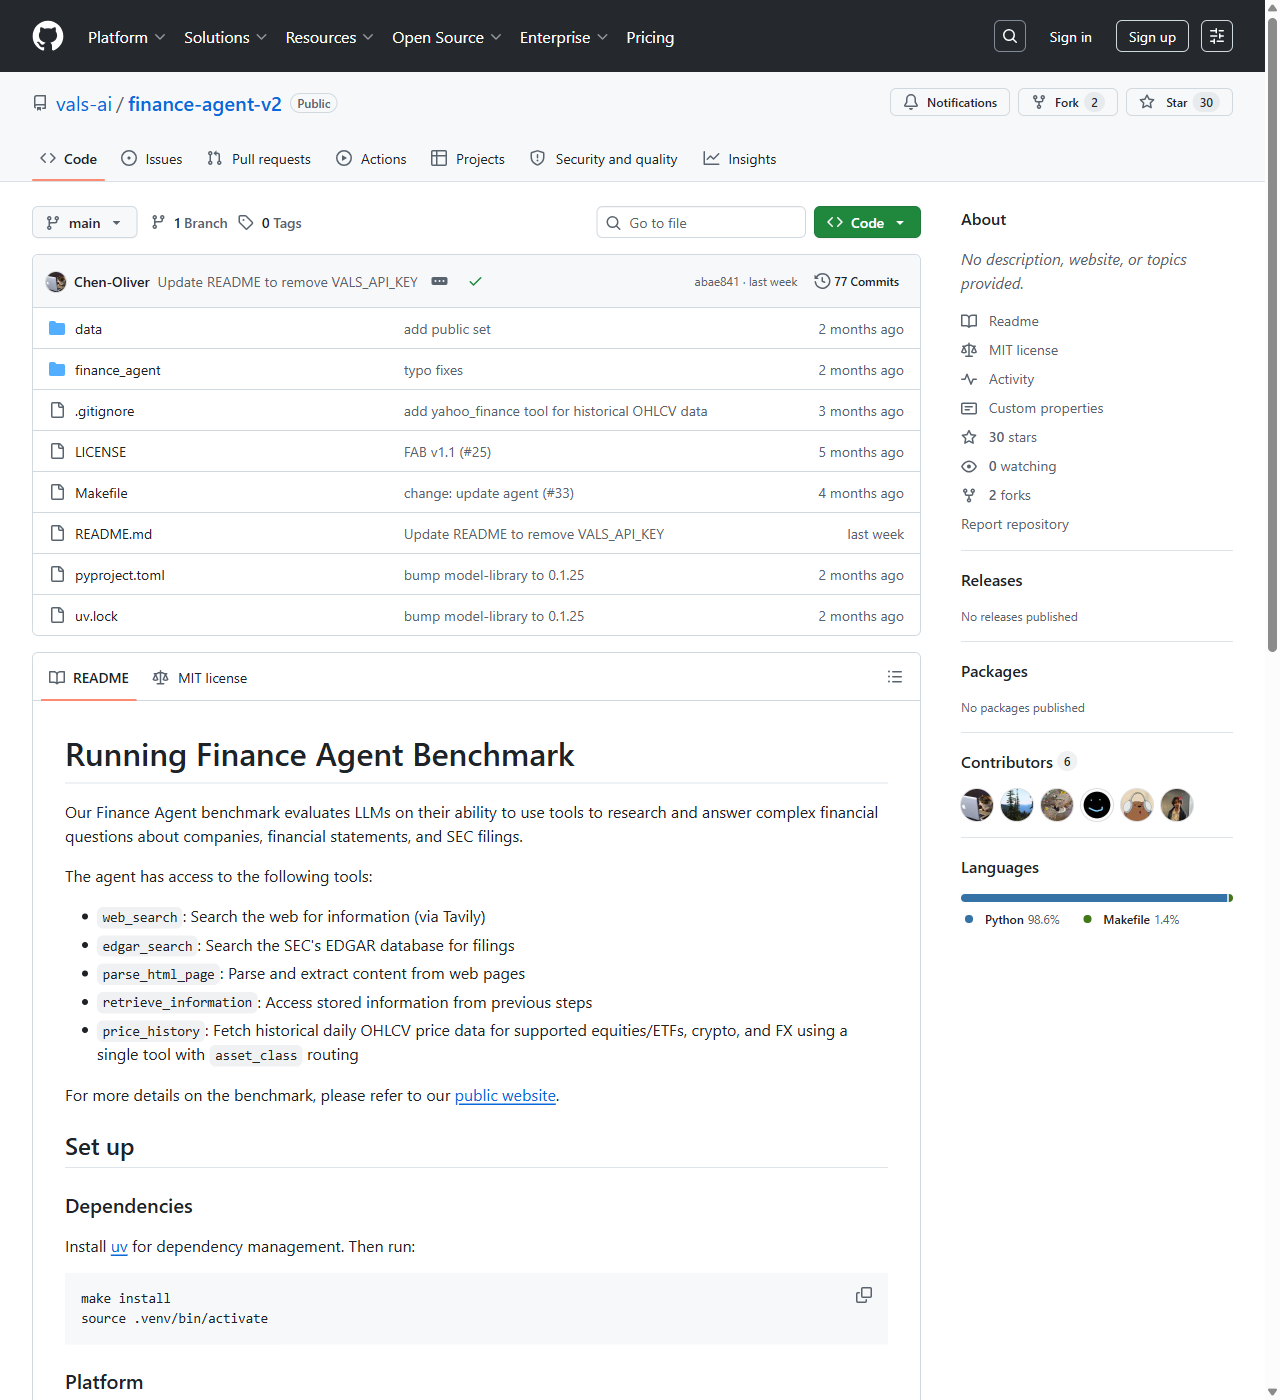
La estructura es pequeña y fácil de leer. data/ contiene public.csv, el conjunto público de preguntas junto con sus rúbricas. finance_agent/ es el paquete de Python que hace el trabajo: run_agent.py es el punto de entrada que le entrega las herramientas al modelo elegido y lo ejecuta sobre una pregunta, y tools.py define las cinco herramientas que el agente puede usar: búsqueda de reportes en EDGAR, búsqueda web, parseo de páginas HTML, recuperación de información almacenada e historial de precios. El Makefile instala todo, y pyproject.toml con uv.lock fijan las dependencias. Encima de eso agregué mi propio run_bench.py, un wrapper con checkpoints que corre el harness pregunta por pregunta y guarda cada respuesta, así un fallo o una key agotada nunca pierde ni vuelve a cobrar trabajo ya terminado.
Para correrlo conectas algunas APIs: Tiingo para datos de mercado y precios, EDGAR para buscar reportes a través de la API de la SEC, y Tavily para búsqueda web. Todas tienen planes gratuitos, pero el de la SEC es mínimo y se agota rápido, así que en la práctica creas un par de cuentas y rotas varias keys (una lista simple separada por punto y coma, que se alterna en cada llamada) para mantener viva una corrida larga.
Tú eliges los modelos: cualquier IA que quieras comparar, solo agrega sus keys, así que no estás limitado a mis dos. Pero ojo, esto no es gratis ni rápido. Cada pregunta obliga al modelo a comportarse como un analista real: una docena o más de llamadas a herramientas, reportes en vivo, búsquedas web reales. Cada pregunta cuesta dinero real en API y puede tardar varios minutos de tiempo real. Correr el conjunto completo de 537 preguntas con dos modelos puede sumar bastante en facturas de API y llevar casi un día entero, así que empieza con un piloto pequeño antes de comprometerte con una corrida completa.
Hay un límite de tiempo por pregunta que defines con --max-time, y si lo configuras mal arruina la corrida sin avisar. Primero probé un límite ajustado de unos 400 segundos, y simplemente no le alcanzó a Gemini: como agente hace muchas llamadas a herramientas por pregunta, chocaba con el límite a mitad de la investigación y se cortaba, así que la respuesta volvía vacía. Subir el límite a unos 1000 segundos o más lo resolvió. El GPT barato es rápido y no razona, así que termina holgadamente dentro de los 400 segundos, pero los modelos agénticos fuertes son lentos y deliberados, así que planifica límites largos por pregunta y corridas totales largas.
Un hábito que vale la pena mantener antes de correr cualquier cosa que bajes de GitHub, este repo incluido: verifica la fuente y agrega primero tus propias protecciones. Todo el tiempo salen noticias de código malicioso escondido en repositorios y paquetes, así que revisa quién es realmente el autor, confirma que estás en el proyecto real y no en un fork que lo imita, y lee los scripts de entrada para ver qué ejecutan y qué envían por la red antes de correrlos. Nunca ejecutes un paso de registro o de "desbloqueo" que te pida nombre o email, y solo conecta tus API keys cuando estés convencido de que es seguro. Por eso mismo, lo primero que hace el prompt de abajo es obligar a Claude a leer los puntos de entrada y demostrar que son seguros antes de correr una sola línea.
Hay una pieza que no es open source: el evaluador de vals.ai, lo que realmente califica las respuestas. Así que armé el mío. Uso Claude Opus como orquestador. Corre cada modelo sobre las preguntas y luego califica cada respuesta contra la rúbrica publicada por vals.ai, una lista de verificación exacta tomada del paper. No es un competidor y nunca responde una pregunta de finanzas por su cuenta: su único trabajo es correr los modelos y luego juzgarlos línea por línea. Misma planilla, mismo estándar, sin favoritismos. No necesitas tocar el repo en crudo ni manejar keys a mano para hacerlo: puedes apuntar tu suscripción de Claude al repo público y pedirle que arme la corrida, agregue las protecciones y califique los resultados. Este es el prompt exacto que usé:
Enfrenté al número uno actual, Gemini 3.5 Flash, con un modelo deliberadamente barato y desactualizado, GPT-4.1 mini, para mantener razonables los costos de API y mostrar la diferencia pura que hace el modelo. Opus calificó cada respuesta contra la rúbrica de vals.ai, punto por punto, tal como describí arriba: cada ítem de la rúbrica marcado como acierto o fallo, más una verificación de contradicciones, y el puntaje es la proporción de puntos acertados. En el piloto, Gemini logró el 95% de los puntos de la rúbrica y GPT-4.1 mini el 25%. Eso no es una brecha, es un abismo.
Y la razón no fue la inteligencia pura. En una pregunta sobre revelaciones, Gemini leyó ambos 10-K y acertó. El modelo barato tomó el reporte del año equivocado, sacó datos de un sitio de screening de acciones y concluyó exactamente lo contrario. Cuando miras las respuestas, Gemini cita las URLs reales de los reportes en la SEC, mientras que el modelo barato cita comunicados de prensa y MarketBeat. Esa es toda la historia. Si no obligas a un modelo a pasar por la fuente primaria, agarra la fuente más cómoda que tenga a mano, y en finanzas la fuente más cómoda es la forma de terminar equivocado y seguro de ti mismo al mismo tiempo.
El modelo barato no era tonto. Solo confió en la fuente más cómoda en lugar del reporte.
La verdadera lección no es "usa Gemini". Los modelos cambian, las preguntas no. Arma el benchmark, obliga a cualquier modelo a pasar por fuentes primarias y deja que un juez neutral lo califique contra una rúbrica fija. Así descubres qué IA es realmente la mejor para tu trabajo, y no la mejor en la diapositiva de alguien.
Fuente del benchmark: vals.ai Finance Agent v2. Harness open source: vals-ai/finance-agent-v2. Paper: Bigeard, Nashold, Krishnan & Wu (2025), arXiv:2508.00828. Todas las cifras del ranking son una foto del 4 de julio de 2026 y ya habrán cambiado; reprodúcelas antes de citarlas.